Asia/Seoul
Blog

연결은 됐지만, 운영은 쉽지 않았다! 온프레미스 MQTT에서 AWS IoT Core로 마이그레이션한 이유

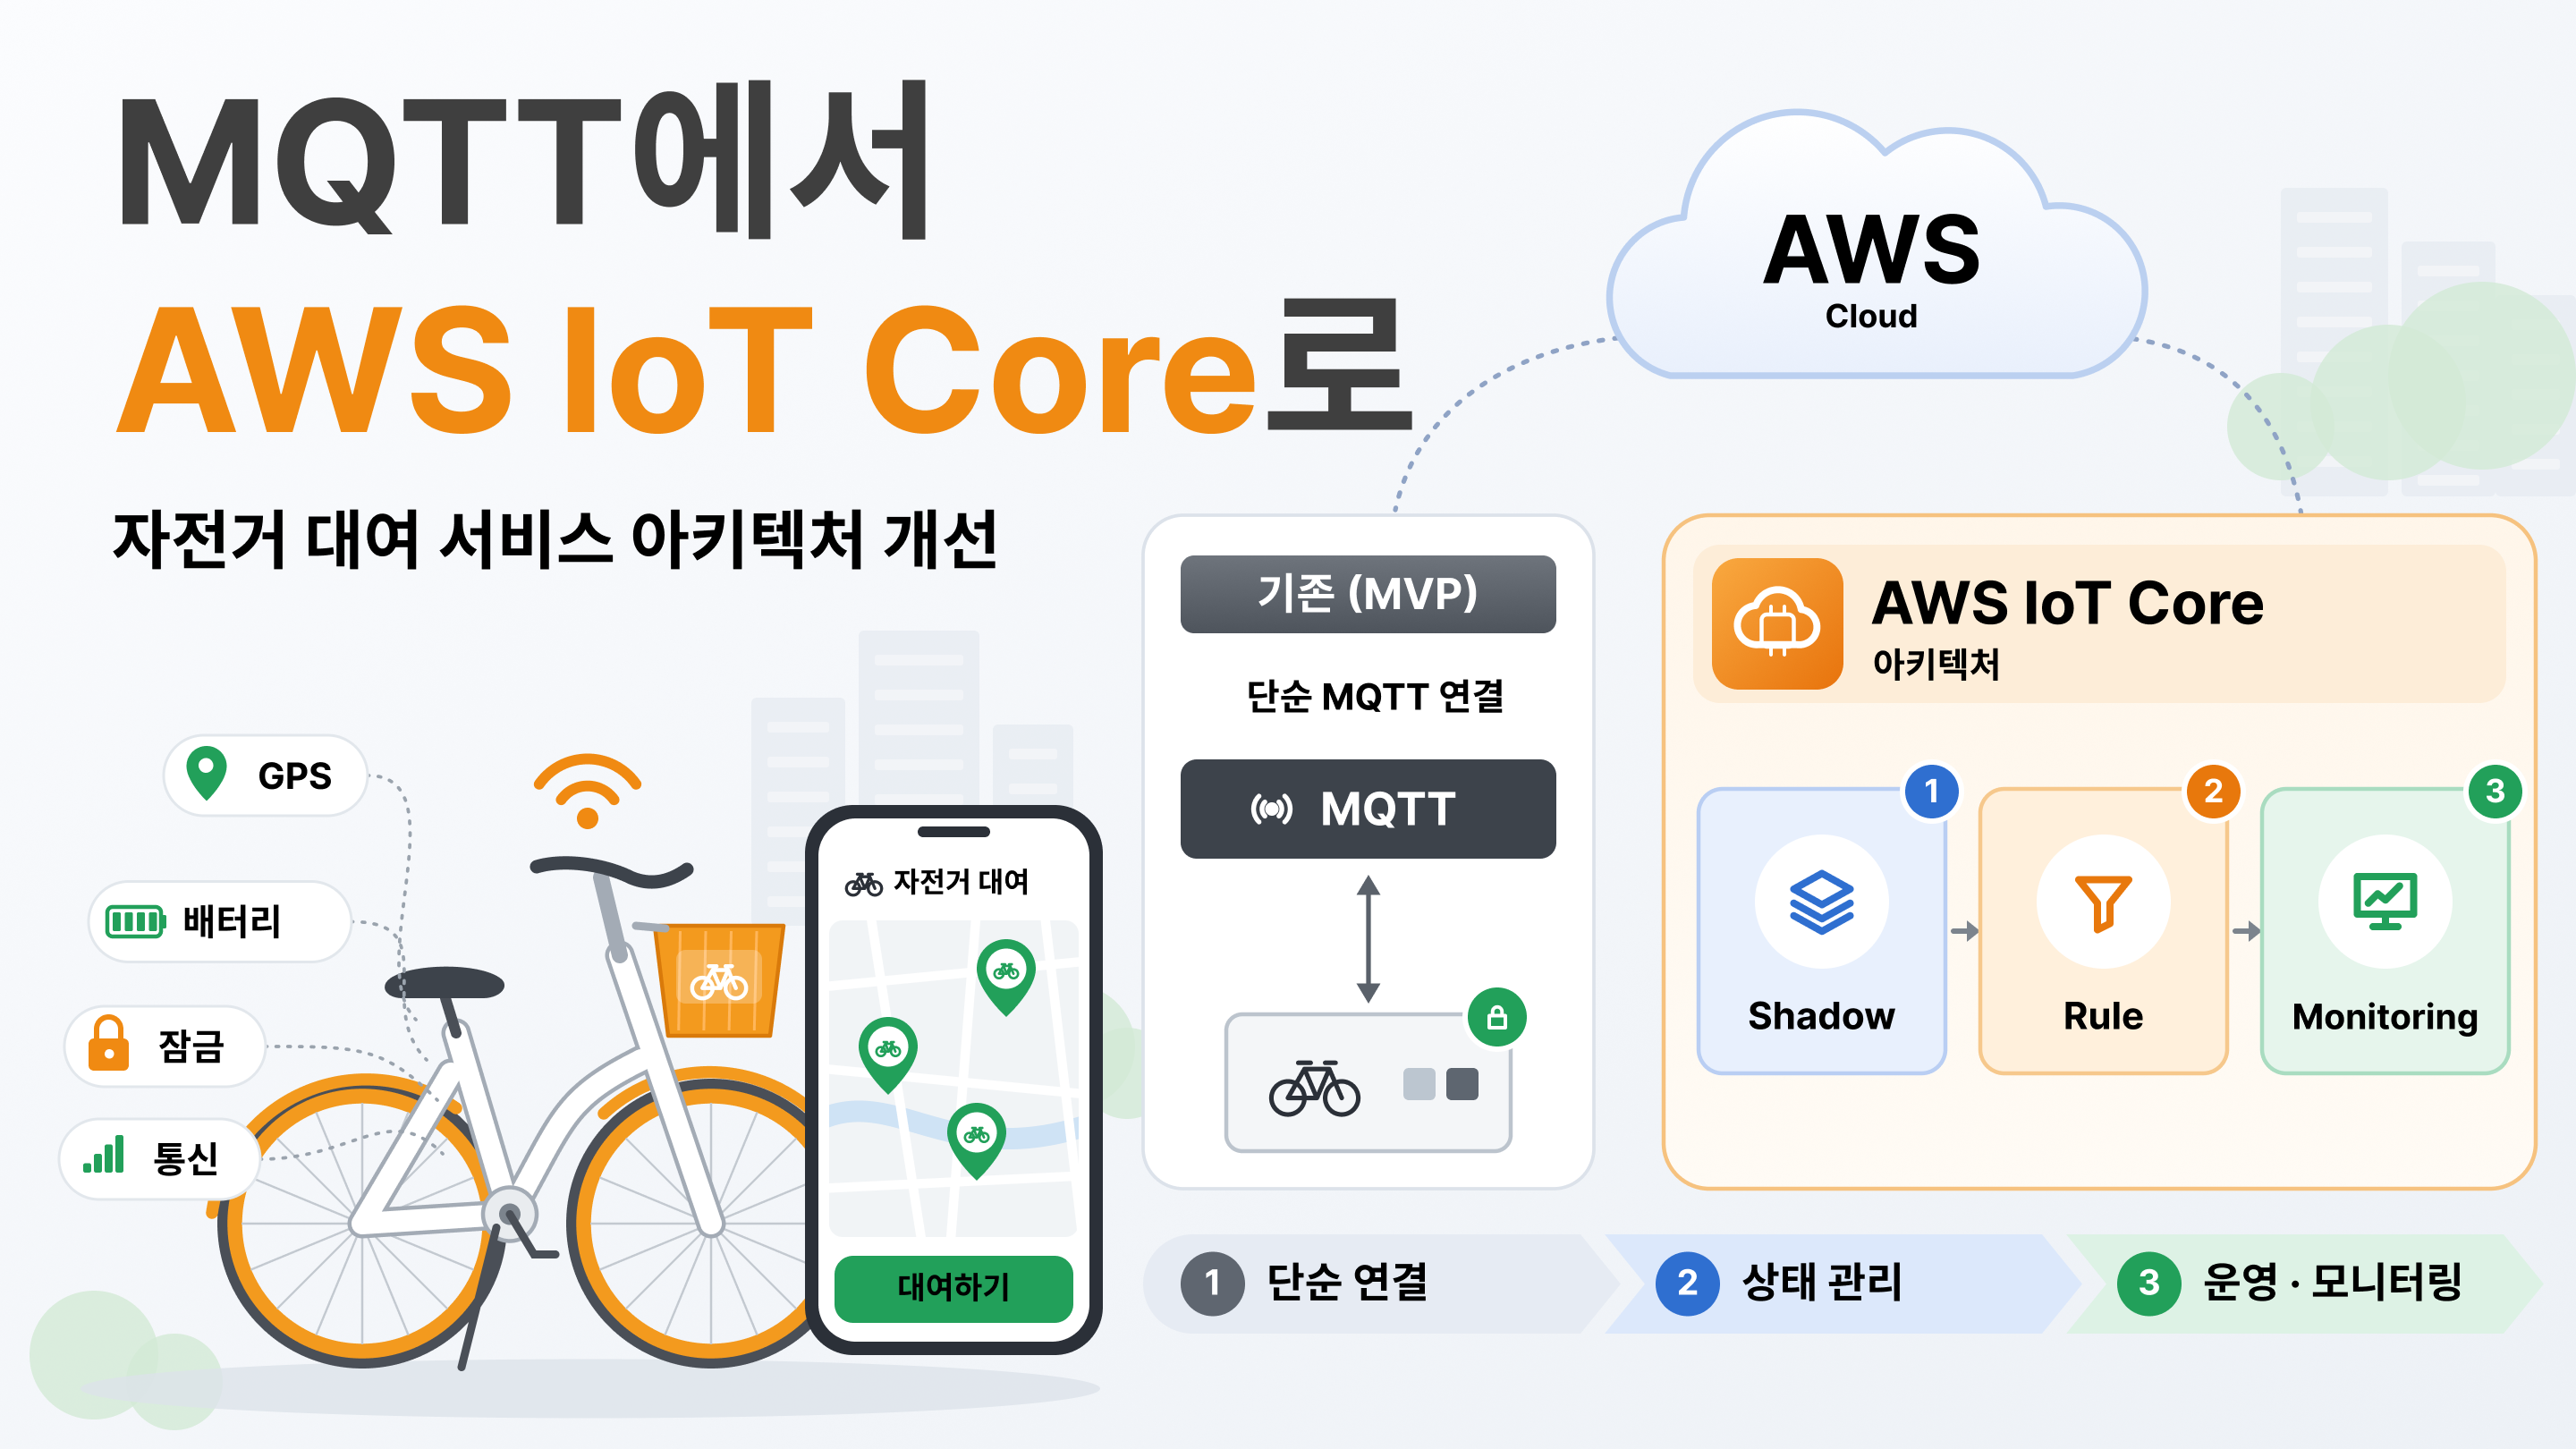
온프레미스 MQTT 브로커로 디바이스 연결에는 성공했지만, 실제 서비스 운영에서는 예상하지 못한 문제들이 발생했습니다. 어떤 한계에 부딪혔고, 왜 AWS IoT Core로 마이그레이션을 결정했는지 그 과정과 개선 효과를 공유합니다.
Alisher Togayev37 min read
연결은 됐지만, 운영은 쉽지 않았다! 온프레미스 MQTT에서 AWS IoT Core로 마이그레이션한 이유
  1. 연결만 잘되면 끝인 줄 알았다
    • 처음부터 완벽한 아키텍처를 만들 필요가 있을까?
    • MVP 개발과 실제 서비스 운영의 차이
  2. 초기 MVP 아키텍처 — 온프레미스 MQTT로도 충분했다
    • 자전거 대여 서비스의 요구사항
    • RabbitMQ와 MQTT Pub/Sub를 선택한 이유
    • MQTT Topic 구조와 메시지 인터페이스
    • 기본적인 자전거 대여 및 반납 흐름
  3. 실제 운영을 생각하니 문제가 보이기 시작했다
    • 디바이스가 오프라인이 된다면?
    • 서버와 실제 디바이스 상태가 서로 다르다면?
    • 펌웨어 업데이트와 디바이스 관리 문제
    • 고객사가 늘어날수록 복잡해지는 운영 구조
    • 기술적 문제가 비즈니스에 미치는 영향
  4. 왜 AWS IoT Core를 선택했을까?
    • 기존 MQTT 브로커를 계속 사용하면 안 될까?
    • AWS, Azure 및 다른 클라우드 서비스 비교
    • AWS IoT Core가 제공하는 주요 기능
    • 마이그레이션을 결정할 때 고려한 기준
  5. 무엇을 어떻게 바꿨을까? — 개선된 아키텍처
    • Thing Registry, X.509 인증서, IoT Policy
    • Device Shadow를 활용한 상태 동기화
    • IoT Rules, SQS, Lambda 기반 이벤트 처리
    • CloudWatch 모니터링 및 장애 추적
    • IoT Jobs를 활용한 OTA 관리 방향
  6. 기존 MQTT에서 AWS IoT Core로 옮기는 과정
    • 디바이스 등록 및 인증서 구성
    • 기존 Topic과 메시지 호환성
    • 단계별 마이그레이션
    • 테스트 및 롤백 전략
  7. 실제 운영 시나리오로 살펴보기
    • 자전거 대여 중 연결이 끊어진다면?
    • 서버와 디바이스의 설정이 다르다면?
    • 배터리 부족 이벤트가 발생한다면?
    • 고객사별로 디바이스를 구분해야 한다면?
  8. 아키텍처 개선이 비즈니스에 어떤 가치를 줄까?
    • 운영 및 유지보수 부담 감소
    • 장애 대응 및 상태 관리 개선
    • 신규 디바이스 확장과 운영 자동화
    • Before / After 비교 및 측정 지표
  9. 마치며 — 이번 개선을 통해 배운 점
    • AWS IoT Core가 모든 문제의 정답은 아니다
    • 비용과 운영 복잡성 사이의 Trade-off
    • 다음 프로젝트에서 고려할 점
처음부터 복잡한 시스템을 설계하기보다, 비즈니스 요구사항(개발 기간, 비용, 예상 이용자 수 등)을 고려하여 MVP에 필요한 기능부터 개발하는 것이 중요하다고 생각합니다. 초기 MVP에서는 디바이스가 연결되고, 필요한 메시지를 주고받고, 사용자가 정상적으로 서비스를 이용할 수 있다면 목표를 달성한 셈일 수 있습니다. 그런데 서비스가 성장하면서 정말 어려워지는 부분은 단순한 연결이 아니라 그 이후의 운영이었습니다. 처음에는 디바이스 몇 대가 연결되어 있는지만 확인하면 충분했는데, 나중에는 각각 어떤 상태인지, 마지막으로 언제 데이터를 보냈는지, 명령이 실제로 적용되었는지까지 확인해야 합니다. 문제가 발생했을 때도 마찬가지입니다. 처음에는 개발자가 로그를 직접 확인하고 문제를 해결할 수 있었지만, 디바이스와 고객사가 늘어나면 언제까지나 이런 방식으로 운영하기는 어렵습니다. 결국 중요한 것은 디바이스가 연결되어 있느냐가 아니라, 연결된 디바이스를 얼마나 안정적이고 편리하게 운영할 수 있느냐였습니다. 이런 문제를 조금 더 쉽게 이해하기 위해, 이번 글에서는 자전거 대여 서비스를 예시로 살펴보겠습니다. 이번 블로그에서는 여러 기업의 직원들이 이용할 수 있는 B2B 자전거 대여 서비스를 가정하겠습니다. 사용자는 모바일 앱에서 가까운 자전거를 찾고, 대여한 후 목적지까지 이동하여 반납할 수 있습니다. 회사에서는 자전거의 위치, 배터리 상태, 대여 현황 등을 확인하고 관리할 수 있어야 합니다.
구분요구사항상세 내용
사용자 규모초기 이용자 100~1,000명기업 고객사의 직원들이 주로 이용
백엔드 서비스자전거 및 대여 관리 API자전거 등록, 대여·반납, 사용자 인증, 결제 또는 이용료 정산
자전거 디바이스MCU 기반 IoT 장비GPS 위치, 배터리 잔량, 잠금 상태 측정
디바이스 통신MQTT 기반 양방향 통신상태 데이터 전송 및 제어 명령 수신
모바일 앱자전거 대여 서비스주변 자전거 조회, 대여 및 반납, 배터리 상태 확인
여기서 사용자 수와 실제 연결되는 자전거 수는 다릅니다. 초기에는 비교적 적은 수의 자전거로 서비스를 검증하고, 이후 고객사와 디바이스 수가 증가하는 상황을 가정하겠습니다. 초기 MQTT 브로커로 RabbitMQ를 사용한다고 가정해 보겠습니다. RabbitMQ는 AMQP 기반 메시징 기능을 제공하고, MQTT Plugin을 활성화하면 MQTT 클라이언트도 연결할 수 있습니다. 이미 RabbitMQ를 사용해 본 경험이 있거나 관련 인프라를 운영하고 있다면, 초기 MVP에서 충분히 고려할 만한 선택입니다. 특히 다음과 같은 장점들이 있습니다.
  • 배포 환경: 일부 B2B 고객사는 클라우드보다 자체 서버나 온프레미스 환경을 선호합니다. RabbitMQ는 컨테이너 기반으로 이런 환경에도 배포할 수 있습니다.
  • 비용: 기존 서버와 운영 환경을 활용할 수 있다면 초기 비용을 줄일 수 있습니다. 다만 서버 유지보수와 운영 인력의 비용도 함께 고려해야 합니다.
  • 단순한 구조: 초기에는 telemetry, status, cmd, ack 정도의 Topic만으로도 기본적인 데이터 송수신과 제어가 가능합니다.
  • 개발 편의성: 디바이스와 백엔드가 MQTT를 통해 메시지를 주고받는 구조가 비교적 단순하고 직관적입니다.
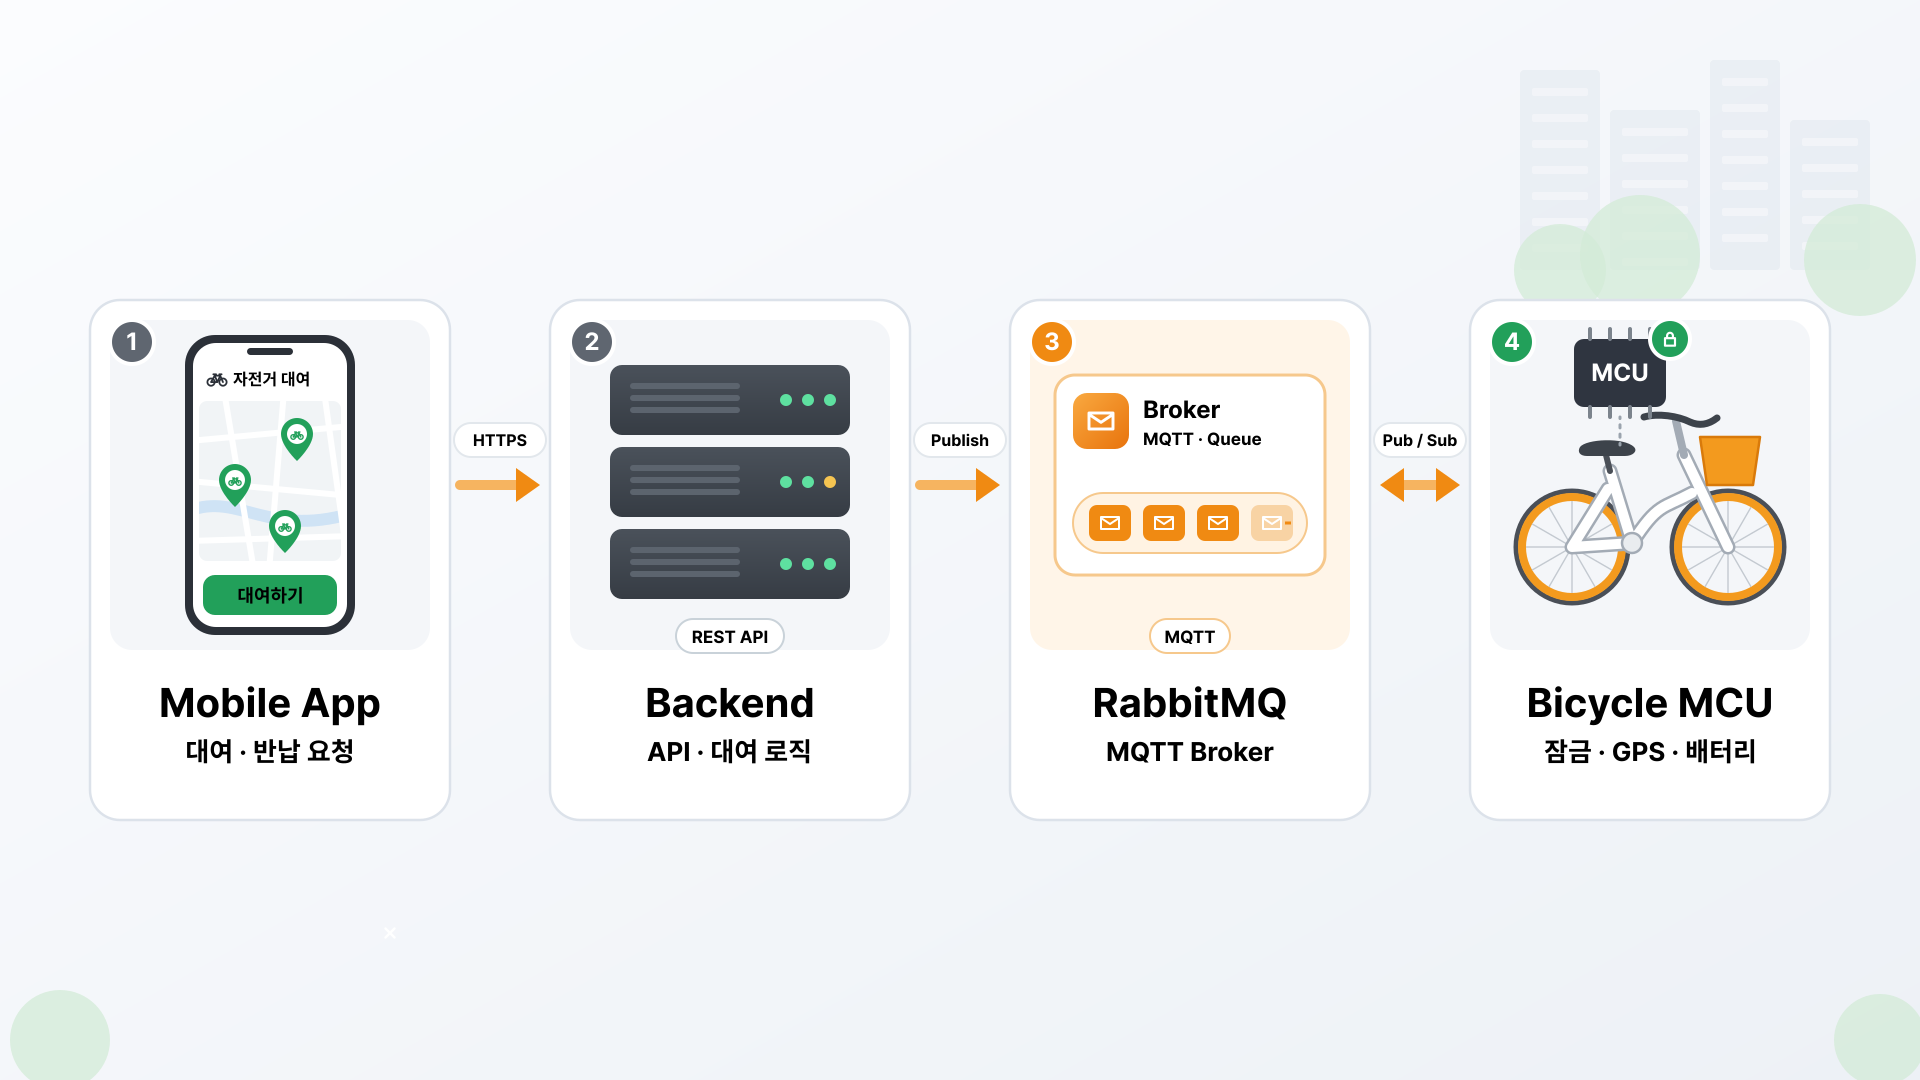
즉, 처음부터 AWS IoT Core와 같은 관리형 서비스가 반드시 필요한 것은 아닙니다. 서비스의 규모와 요구사항에 따라 기존 MQTT 브로커만으로도 충분히 좋은 구조를 만들 수 있습니다.
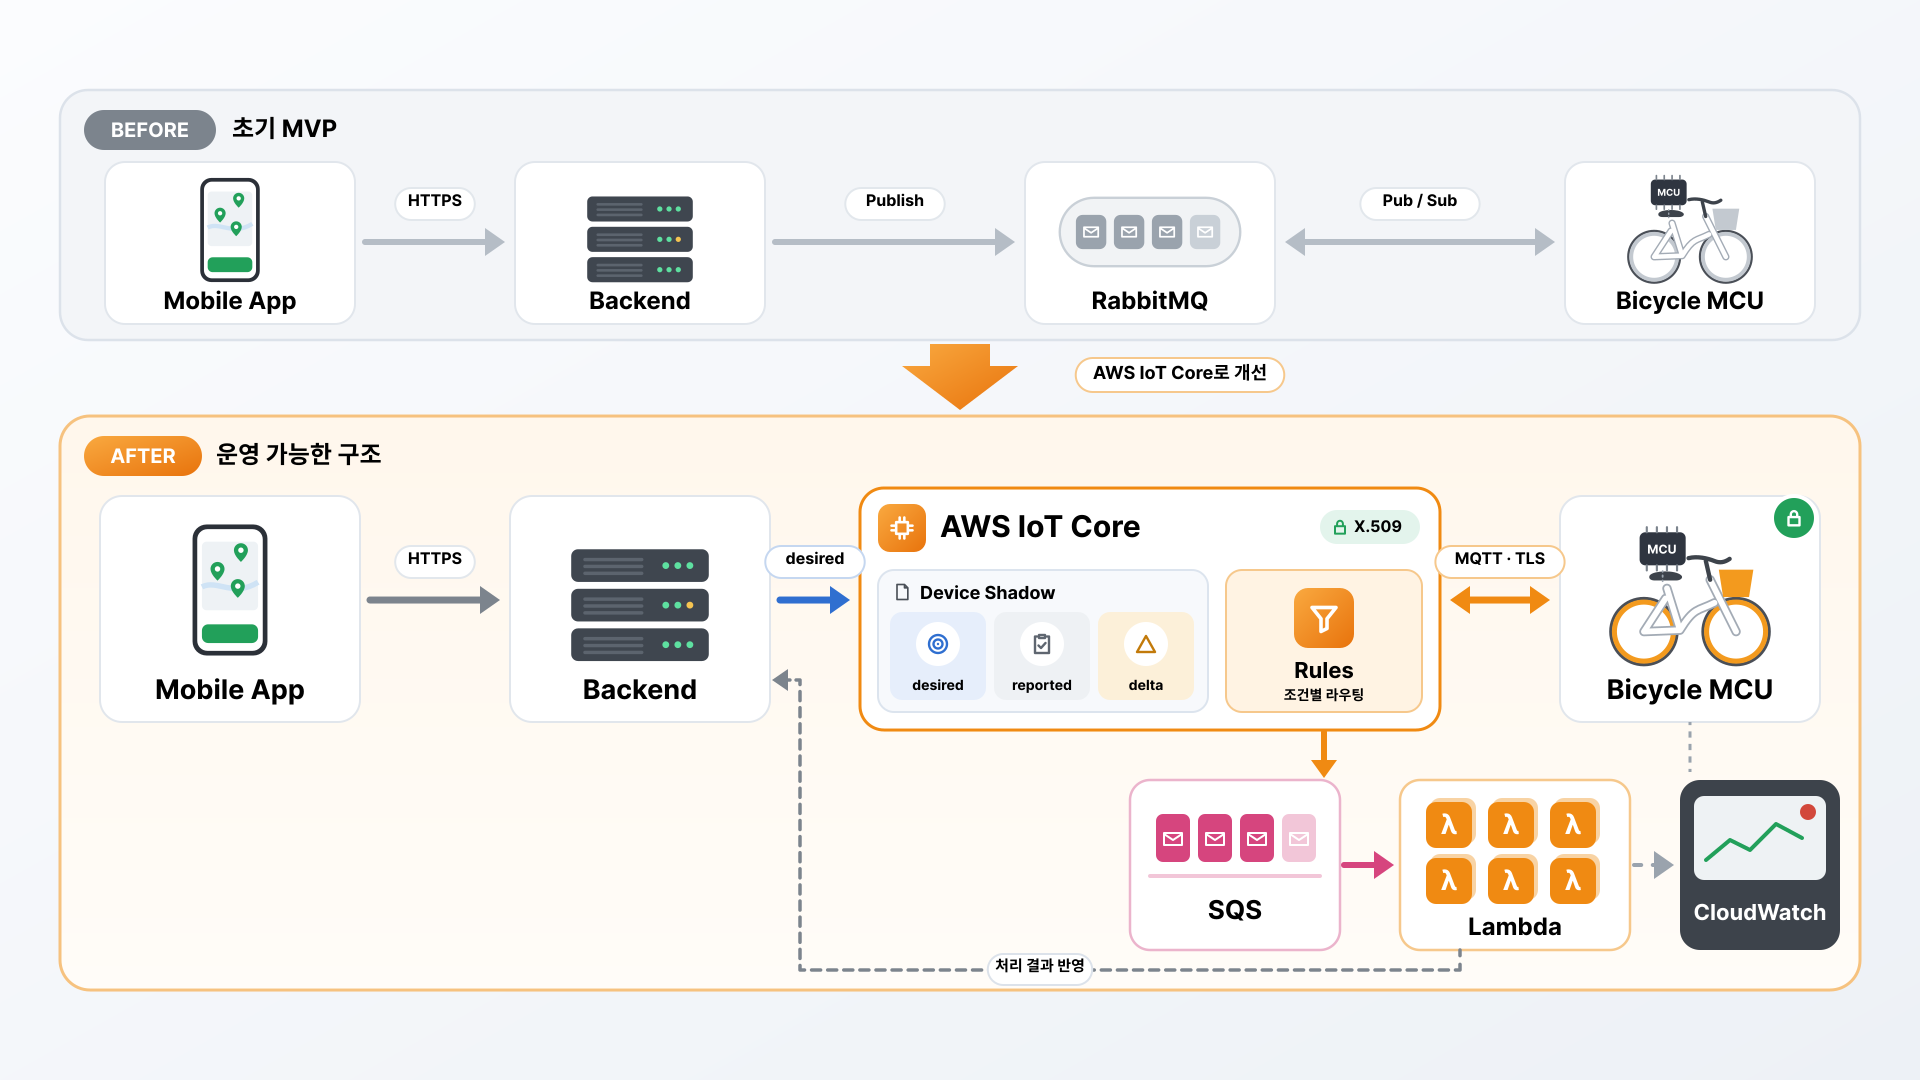
초기 MVP 아키텍처: Mobile App → Backend → RabbitMQ MQTT Broker ↔ Bicycle MCU
초기에는 아래와 같이 단순한 Topic 구조를 사용하겠습니다.
Text
bike/
└── {bikeId}/
    ├── telemetry   # GPS, 배터리, 속도
    ├── status      # 잠금 상태, 디바이스 상태
    ├── cmd         # 잠금, 잠금 해제 명령
    └── ack         # 명령 실행 결과
{bikeId}는 자전거마다 부여되는 고유한 ID입니다. 예를 들어 B001 자전거의 GPS 데이터를 받고 싶다면 bike/B001/telemetry를 구독하면 됩니다. 여러 자전거의 데이터를 수신해야 한다면 bike/+/telemetry와 같은 MQTT Topic Filter를 사용할 수도 있습니다. 각 Topic의 역할은 다음과 같습니다.
Topic방향역할
telemetry자전거 → 클라우드GPS, 배터리, 이동 속도
status자전거 → 클라우드잠금 상태 및 동작 상태
cmd클라우드 → 자전거LOCK, UNLOCK 명령
ack자전거 → 클라우드명령 실행 결과
메시지는 JSON 형식으로 구성하고, 시간 정보는 Unix Timestamp(초 단위)를 사용하겠습니다. 1. telemetry — 자전거 위치 및 센서 데이터
Json
{
  "gps": {
    "latitude": 37.5666,
    "longitude": 126.9780
  },
  "speed": 10,
  "battery": 80,
  "timestamp": 1793937600
}
자전거가 이동하면서 GPS 위치와 배터리 상태를 클라우드로 전송합니다. 이 데이터를 이용하여 모바일 앱에 자전거의 마지막 위치와 배터리 잔량을 표시할 수 있습니다. 2. status — 디바이스 상태
Json
{
  "lock_state": "locked",
  "device_state": "online",
  "status": "stopped",
  "timestamp": 1793937600
}
현재 잠금 상태와 디바이스 동작 상태를 전달합니다. 다만 자전거가 갑자기 오프라인이 되면 직접 offline 메시지를 보내지 못할 수 있습니다. 이런 경우 MQTT Last Will이나 서버 측 연결 상태 감지 로직이 필요합니다. 3. cmd — 디바이스 제어 명령
Json
{
  "command_id": "cmd001",
  "action": "UNLOCK",
  "timestamp": 1793937600,
  "expires_at": 1793937630
}
사용자가 대여를 요청하면 백엔드에서 이용 가능 여부와 권한을 확인한 후 자전거로 명령을 전송합니다. 여기서 expires_at은 명령의 유효시간입니다. 예를 들어 잠금 해제 명령을 보낸 지 한참 지난 후 자전거가 다시 연결되었다고 해서 이전 명령이 실행되면 안 되겠죠. 따라서 잠금 해제와 같은 명령은 반드시 유효시간과 중복 실행 여부를 확인해야 합니다. 4. ack — 명령 실행 결과
Json
{
  "command_id": "cmd001",
  "action": "UNLOCK",
  "result": "SUCCESS",
  "lock_state": "unlocked",
  "timestamp": 1793937602
}
자전거가 잠금 해제 명령을 수행한 후 결과를 전송합니다. command_id를 통해 어떤 명령에 대한 결과인지 확인할 수 있습니다. 이때 중요한 점은 MQTT 메시지가 전달되었다는 것과 실제 잠금 장치가 해제되었다는 것은 다르다는 점입니다. ACK는 디바이스가 실제 하드웨어 상태를 확인한 후 전송하도록 구현해야 합니다. 기본적인 대여 과정은 생각보다 단순합니다.
  1. 사용자가 앱에서 자전거 대여를 요청합니다.
  2. 백엔드에서 사용자와 자전거의 이용 가능 여부를 확인합니다.
  3. MQTT cmd Topic으로 잠금 해제 명령을 전송합니다.
  4. 자전거가 명령을 실행하고 ack를 전송합니다.
  5. 백엔드는 실행 결과를 확인한 후 대여를 시작합니다.
  6. 사용자가 반납하면 잠금 상태와 반납 조건을 확인하고 대여를 종료합니다.
이용 시간과 이동 거리는 백엔드에서 관리합니다. 이용 시간은 검증된 대여 시작 및 종료 시각을 기준으로 계산하고, 이동 거리는 디바이스에서 받은 GPS 데이터나 주행 거리 센서 정보를 활용할 수 있습니다. 반납 시에는 자전거가 잠겼다는 사실뿐 아니라 실제 대여 세션, 위치 및 반납 조건도 확인해야 합니다. 여기까지 구현하면 MVP에서 필요한 기본적인 서비스 흐름은 완성할 수 있습니다. 그런데 실제로 운영을 시작한다고 생각하면 몇 가지 문제가 보이기 시작합니다.
서비스를 출시한 다음에는 매일 문제가 발생하는 것은 아니더라도 가끔 예상하지 못한 상황이 생길 수 있습니다. 처음에는 간단한 수정이나 업데이트로 해결할 수 있었던 문제도 사용자 수와 디바이스 수가 늘어나면서 점점 복잡해집니다. 자전거는 서버처럼 항상 안정적인 네트워크에 연결되어 있는 장비가 아닙니다. 이동 중 통신이 끊길 수도 있고, 배터리가 부족하거나 하드웨어 문제가 발생할 수도 있습니다. 예를 들어 사용자가 자전거 대여 버튼을 눌렀는데, 마침 해당 자전거가 오프라인 상태라면 어떻게 될까요? 백엔드에서 MQTT 명령을 발행했더라도 디바이스가 실제로 수신하지 못할 수 있습니다. 그런데 서버에서 명령 전송만으로 대여에 성공했다고 처리한다면 사용자는 요금이 시작되었는데 자전거를 이용하지 못하는 상황을 겪을 수도 있습니다. 기술적으로는 메시지 전달 문제지만, 비즈니스 관점에서는 대여 실패와 고객 불편으로 이어지는 문제입니다. 자전거가 가진 정보를 서버 데이터베이스에 저장해 두었다고 해도 문제가 완전히 해결되는 것은 아닙니다. 예를 들어 서버에는 자전거의 잠금 상태가 locked로 저장되어 있는데, 실제 디바이스에서는 이미 잠금이 해제된 상황을 생각해 보겠습니다. 일시적인 인터넷 장애나 메시지 유실로 인해 두 상태가 서로 달라질 수 있습니다. 이런 상황을 흔히 상태 불일치 또는 State Inconsistency라고 부릅니다. 그렇다면 서버와 디바이스 중 어떤 데이터를 믿어야 할까요? 모든 상황에서 하나의 답을 정하기는 어렵습니다. 실제 잠금 장치의 상태는 디바이스에서 확인해야 하고, 대여 가능 여부와 요금 처리는 백엔드의 비즈니스 로직에서 판단해야 하기 때문입니다. 따라서 어떤 상태를 어디에서 관리하고, 서로 다를 때 어떻게 동기화할지 정하는 것이 중요해집니다. 사용자가 자전거를 이용하는 도중 배터리가 방전되었다고 가정해 보겠습니다. 디바이스가 종료되면 더 이상 GPS 위치나 잠금 상태를 전송할 수 없습니다. 서버에는 마지막으로 수신한 위치가 남아 있겠지만, 그것이 실제 현재 위치라고 보장할 수는 없습니다. 게다가 진행 중인 대여를 정상적으로 종료하지 못할 수도 있습니다. 그래서 단순히 위치 정보를 저장하는 것뿐만 아니라 다음과 같은 정보도 필요합니다.
  • 마지막으로 데이터를 받은 시각
  • 마지막으로 확인된 GPS 위치
  • 배터리 잔량과 연결 상태
  • 현재 진행 중인 대여 세션
  • 통신 장애 시 대여 종료 및 요금 처리 정책
특히 운영팀 입장에서는 어떤 자전거를 먼저 점검해야 할지 빠르게 파악할 수 있어야 합니다. 자전거가 10대라면 하나씩 업데이트하는 것도 크게 어렵지 않을 수 있습니다. 그런데 100대, 500대, 1,000대로 늘어난다면 어떨까요? OTA(Over-The-Air)를 이미 구현했다고 해도 모든 문제가 해결되는 것은 아닙니다. 하드웨어 모델마다 다른 펌웨어를 사용하거나, 고객사별 설정이 코드에 포함되어 있다면 매번 별도로 빌드하고 배포해야 할 수도 있습니다. 업데이트가 실패했을 때 어떤 장비에서 실패했는지 확인하는 것도 중요합니다. 원격으로 복구할 수 없다면 결국 개발자나 운영 담당자가 직접 방문해야 할 수도 있습니다. 이런 상황이 반복되면 개발 시간뿐만 아니라 현장 유지보수 비용도 증가하게 됩니다. 처음에는 하나의 회사에서만 자전거를 이용한다고 가정해 보겠습니다. 그런데 나중에 여러 기업이 같은 서비스를 이용하기 시작하면 요구사항도 달라집니다. A 회사에서는 자전거 위치를 10초마다 확인하고 싶어 하고, B 회사에서는 배터리 절약을 위해 30초마다 확인하고 싶어 할 수 있습니다. 또한 A 회사의 관리자가 B 회사의 자전거에 접근해서는 안 됩니다. 즉, 단순한 Topic 구분만으로는 부족할 수 있습니다. 디바이스별 인증과 접근 권한, 고객사별 데이터 분리, 설정 관리까지 함께 고려해야 합니다. 이런 요구사항을 기존 시스템에서 직접 개발할 수도 있습니다. 하지만 기능을 하나씩 추가할수록 운영하고 유지보수해야 하는 부분도 늘어나게 됩니다. 결국 MQTT 브로커를 운영하는 것과 IoT 디바이스 전체를 관리하는 것은 서로 다른 문제라는 생각이 들었습니다.
시간이 지나면서 서비스에 필요한 기능이 늘어나고, 고객사마다 다른 요구사항을 지원해야 한다면 기존 아키텍처를 다시 살펴볼 필요가 있습니다. 그렇다고 바로 AWS로 옮기는 것이 정답일까요? 꼭 그렇지는 않습니다. 물론 가능합니다. RabbitMQ를 그대로 사용하면서 필요한 기능을 직접 구현하는 방법도 있습니다. 예를 들어 디바이스 상태를 데이터베이스에 저장하고, 별도의 서비스를 만들어 상태 동기화와 인증서 관리, OTA 작업 등을 처리할 수 있습니다. 이런 방식의 장점은 원하는 구조를 자유롭게 설계할 수 있다는 것입니다. 하지만 직접 개발한 기능은 이후에도 직접 유지보수해야 합니다. 서버 운영, 메시지 처리, 인증서 관리, 장애 대응, 업데이트 시스템까지 모두 관리해야 한다면 실제 비즈니스 기능 개발에 사용할 시간이 줄어들 수도 있습니다. 그래서 이 사례에서는 MQTT 브로커만 교체하는 것이 아니라, 디바이스 운영에 필요한 기능을 어디까지 직접 관리하고 어디부터 관리형 서비스에 맡길지 고민해 보겠습니다. AWS 외에도 Azure IoT Hub와 같은 관리형 IoT 서비스를 고려할 수 있습니다. Google Cloud와 네이버 클라우드 역시 비교 대상이 될 수 있지만, 기존의 Cloud IoT Core 서비스가 종료되었기 때문에 현재 제공되는 대안이나 별도 솔루션을 검토해야 합니다.
서비스장점고려할 점
RabbitMQ On-Premises기존 인프라 활용, 높은 구성 자유도브로커와 디바이스 운영 기능을 직접 관리
AWS IoT CoreThing Registry, Shadow, Rules, Jobs 및 AWS 서비스 연동사용량 기반 비용, AWS 의존성, 디바이스 수정 필요
Azure IoT HubDevice Twins, 메시지 라우팅, 디바이스 관리 기능Azure 기반 서비스와 운영 체계 검토 필요
Google Cloud파트너 또는 별도 IoT 솔루션과 GCP 서비스 조합 가능기존 Cloud IoT Core는 2023년 종료
NAVER Cloud국내 클라우드 인프라 및 관련 서비스 활용 가능기존 Cloud IoT Core와 IoT Device Hub는 2024년 종료
이 사례에서 AWS를 선택하는 가장 큰 이유는 단순히 AWS IoT Core의 기능이 많기 때문만은 아닙니다. 이미 백엔드 인프라의 상당 부분을 AWS에서 운영하고 있다는 점도 중요합니다. 예를 들어 EKS(Kubernetes), RDS, S3, CloudWatch, CloudFront 등을 사용하고 있다면 새로운 IoT 데이터를 기존 서비스와 연동하기가 상대적으로 편리합니다. 디바이스에서 발생한 이벤트를 IoT Rules로 필터링하고 SQS로 전달한 후, Lambda나 EKS의 워커에서 처리하도록 구성할 수 있습니다. 새로운 클라우드 환경을 별도로 구축하고 관리할 필요가 줄어드는 것이죠. 물론 실제 도입 전에는 메시지 수, 동시 연결 수, Shadow 사용량, Jobs 요청량 등 예상 트래픽을 기준으로 비용을 비교해야 합니다. AWS IoT Core는 대규모 IoT 디바이스를 클라우드에 안전하게 연결하고 MQTT 기반으로 메시지를 주고받을 수 있도록 지원하는 관리형 서비스입니다. 하지만 AWS IoT Core를 선택한 이유는 단순한 MQTT 통신 때문이 아닙니다. 디바이스를 등록하고, 상태를 관리하고, 이벤트를 다른 AWS 서비스로 전달하는 기능을 함께 활용할 수 있다는 점이 중요했습니다. 주요 기능들을 간단히 살펴보겠습니다. 1. Things — 디바이스 등록 및 관리 하나의 하드웨어를 하나의 Thing으로 등록하여 관리할 수 있습니다. 예를 들어 자전거가 100대라면 각각 고유한 Thing을 등록하고 이름, 모델, 설치 위치 등의 정보를 구분할 수 있습니다. X.509 인증서와 IoT Policy를 연결하면 디바이스마다 접근할 수 있는 MQTT Topic과 권한도 제한할 수 있습니다. 2. Shadow — 디바이스 상태 동기화 디바이스가 마지막으로 보고한 상태(Reported)와 서버에서 원하는 상태(Desired)를 관리하는 기능입니다. 예를 들어 자전거의 데이터 전송 간격을 10초에서 30초로 변경하고 싶은데 자전거가 오프라인이라면 어떻게 할까요? Shadow에 원하는 설정을 저장해 두고, 자전거가 다시 연결되었을 때 Delta를 확인하여 적용하도록 만들 수 있습니다. 단, 설정을 실제로 적용하고 결과를 다시 보고하는 로직은 디바이스에 구현해야 합니다. 3. Retain — 마지막 메시지 유지 MQTT 메시지를 발행할 때 RETAIN 옵션을 사용하면 Topic별 마지막 메시지 하나를 저장할 수 있습니다. 새로운 클라이언트가 해당 Topic을 구독했을 때 마지막으로 저장된 메시지를 전달받을 수 있습니다. 다만 Retain은 메시지 이력 저장 기능이 아니며, Shadow의 Desired/Reported 상태 관리와도 목적이 다릅니다. 4. Rules — 메시지 필터링 및 이벤트 처리 하드웨어에서 1초에 1,000개 이상의 메시지가 들어온다고 가정해 봅시다. 그중에서 필요한 데이터만 골라 처리하고 싶다면 어떻게 해야 할까요? IoT Rules에서는 SQL과 비슷한 쿼리를 사용하여 메시지를 필터링하고, 필요한 데이터를 SQS나 Lambda 같은 서비스로 전달할 수 있습니다. 이후 워커에서 데이터를 데이터베이스에 저장하거나 특정 조건에 맞는 경우 관리자에게 알림을 보낼 수 있습니다. 5. Jobs / OTA — 원격 작업 관리 자전거가 100대 이상 설치되어 있는데 펌웨어를 업데이트해야 한다면 어떻게 할까요? 모든 장비를 직접 방문하여 업데이트하기는 어렵겠죠. IoT Jobs를 활용하면 여러 디바이스에 원격 작업을 배포하고 진행 상태를 관리할 수 있습니다. 펌웨어 다운로드, 검증, 설치 등의 기능은 디바이스 측에서 구현해야 하며, 하드웨어 모델별 펌웨어 빌드와 버전 관리도 별도로 필요합니다. 6. Lambda — 이벤트 기반 서버리스 처리 특정한 상황에 자동으로 처리해야 할 작업이 있다면 Lambda를 활용할 수 있습니다. 예를 들어 자전거 배터리가 10% 이하로 내려갔을 때 관리자에게 알림을 보내거나, 특정 이벤트를 데이터베이스에 저장하는 작업입니다. IoT Rules와 Lambda를 연동하면 이런 작업을 위해 별도의 워커 서버를 항상 실행할 필요가 없는 경우도 있습니다. 이 사례에서 AWS IoT Core를 선택한 이유를 정리하면 다음과 같습니다.
  1. 기존 MQTT 통신 기능을 유지하면서 디바이스 관리 기능을 확장할 수 있습니다.
  2. Device Shadow를 통해 원하는 설정과 실제 적용된 상태를 구분하여 관리할 수 있습니다.
  3. Thing Registry, 인증서 및 IoT Policy를 활용해 디바이스별 접근 권한을 관리할 수 있습니다.
  4. IoT Rules를 통해 이벤트 처리 로직을 기존 백엔드와 분리할 수 있습니다.
  5. 이미 사용하고 있는 EKS, S3, RDS, CloudWatch와 연동하기 편리합니다.
  6. 향후 IoT Jobs를 이용하여 원격 작업과 OTA 관리 구조를 개선할 수 있습니다.
여기서 한 가지 강조하고 싶은 점이 있습니다. AWS IoT Core로 옮긴다고 해서 기존 문제가 자동으로 사라지는 것은 아닙니다. 디바이스가 오프라인이 되는 문제는 여전히 발생하고, 펌웨어 로직이나 비즈니스 로직도 직접 구현해야 합니다. 다만 이런 문제를 해결하기 위해 필요한 공통 기능들을 처음부터 모두 직접 만들지 않아도 된다는 점에서 의미가 있습니다.
이제 기존 MQTT 구조를 AWS IoT Core 기반으로 개선한다고 가정해 보겠습니다. 가장 중요한 것은 서비스를 처음부터 다시 만드는 것이 아닙니다. 기존에 잘 동작하던 기능은 최대한 유지하면서, 실제 운영에 필요했던 기능들을 하나씩 개선하는 방향으로 접근하겠습니다.
Before / After 아키텍처: RabbitMQ → AWS IoT Core + Shadow + Rules + SQS/Lambda + CloudWatch
먼저 자전거마다 고유한 Thing을 등록하고 X.509 인증서를 이용하여 AWS IoT Core에 연결하도록 구성합니다. 각 디바이스는 자신의 인증서로 연결하고, IoT Policy를 통해 허용된 Topic에만 접근할 수 있도록 제한합니다. 예를 들어 B001 자전거는 자신의 telemetry, status, ack Topic에 데이터를 발행하고, 자신의 cmd Topic만 구독하도록 설정할 수 있습니다. 다른 자전거의 Topic에는 접근하지 못하도록 하는 것이죠. 이때 Thing 등록, 인증서 발급, 인증서와 Thing 연결, Policy 연결은 서로 구분되는 작업입니다. 고객사가 여러 개라면 고객사별 디바이스 그룹과 권한 체계도 함께 설계해야 합니다. 기존에는 디바이스에서 받은 상태를 데이터베이스에 저장하는 방식으로 관리했다고 가정하겠습니다. 이 방식도 충분히 사용할 수 있지만, 서버가 원하는 설정과 디바이스가 실제 적용한 설정을 비교하려면 별도의 동기화 로직이 필요합니다. Device Shadow를 활용하면 이를 조금 더 명확하게 구분할 수 있습니다. 예를 들어 자전거의 GPS 데이터 전송 간격을 변경한다고 생각해 보겠습니다. 변경 전
Json
{
  "telemetry_interval_sec": 10
}
서버에서 전송 간격을 30초로 변경하고 싶다면 Shadow의 Desired에 새로운 값을 저장할 수 있습니다.
Json
{
  "state": {
    "desired": {
      "telemetry_interval_sec": 30
    }
  }
}
그런데 디바이스가 아직 이 설정을 적용하지 않았다면 실제 Reported 상태는 여전히 10초일 수 있습니다. 이 경우 AWS IoT Core는 Desired와 Reported의 차이를 Delta로 제공합니다. 디바이스가 해당 변경 사항을 수신하고 실제 설정을 30초로 변경한 다음, Reported를 업데이트하도록 구현할 수 있습니다.
Json
{
  "state": {
    "reported": {
      "telemetry_interval_sec": 30
    }
  }
}
이렇게 되면 서버에서는 단순히 명령을 보냈는지뿐 아니라 원하는 설정이 적용되었는지까지 구분하여 확인할 수 있습니다. 다만 Shadow가 있다고 해서 디바이스가 무조건 변경 사항을 적용한다는 의미는 아닙니다. 적용에 실패할 수도 있고, 디바이스가 오랫동안 오프라인 상태일 수도 있습니다. 그래서 Shadow 상태와 함께 마지막 업데이트 시각, 연결 상태, 오류 정보도 확인하는 것이 좋습니다. 또한 자전거의 UNLOCK처럼 즉시 실행되어야 하고 일정 시간이 지나면 무효가 되어야 하는 명령은 Shadow의 지속적인 Desired 설정과 구분하는 편이 안전합니다. 기존 구조에서는 디바이스에서 들어오는 메시지를 백엔드에서 직접 구독하고 처리할 수 있습니다. 이 방식은 단순하지만 메시지 종류와 처리할 작업이 늘어나면 관리해야 할 로직도 많아집니다. 예를 들어 자전거에서 배터리 잔량을 5초마다 전송한다고 가정해 보겠습니다. 모든 메시지를 같은 방식으로 처리할 필요가 있을까요? 대부분의 데이터는 일반적인 상태 정보지만, 배터리가 15% 이하로 떨어지는 상황은 운영팀에서 특별히 확인해야 할 이벤트일 수 있습니다. 이런 경우 IoT Rules에서 필요한 메시지를 선택하여 SQS로 전달하도록 구성할 수 있습니다.
Sql
SELECT *, topic() AS mqtt_topic
FROM 'bike/+/telemetry'
WHERE battery < 15
이후 SQS를 구독하는 Lambda 또는 워커에서 필요한 작업을 처리합니다. 예를 들면 다음과 같습니다.
  • 배터리 부족 이벤트를 데이터베이스에 저장
  • 관리자에게 알림 전송
  • 점검이 필요한 자전거 목록에 추가
  • 반복된 이벤트가 발생하더라도 중복 알림 방지
이렇게 메시지 수신과 후속 작업을 분리하면 백엔드에서 모든 이벤트를 직접 처리하지 않아도 됩니다. 물론 SQS를 사용하면 메시지 중복 처리, 재시도, 실패 메시지 관리도 함께 고려해야 합니다. IoT 서비스에서 중요한 부분 중 하나는 장애가 발생했을 때 원인을 빠르게 찾는 것입니다. 예를 들어 사용자가 자전거 잠금 해제에 실패했다고 문의했다고 생각해 보겠습니다. 원인은 여러 가지일 수 있습니다.
  1. 디바이스가 AWS IoT Core에 연결되지 않았을 수 있습니다.
  2. IoT Policy에서 해당 Topic 접근이 거부되었을 수 있습니다.
  3. 메시지는 전달되었지만 디바이스에서 실행에 실패했을 수 있습니다.
  4. ACK 메시지가 전달되지 않았을 수 있습니다.
  5. 백엔드에서 결과를 처리하는 과정에서 오류가 발생했을 수 있습니다.
이때 어디에서 문제가 발생했는지 확인할 수 있어야 합니다. AWS IoT Core의 로깅과 CloudWatch, Lambda 로그 등을 활용하면 각 단계의 오류를 확인하는 데 도움이 됩니다. 여기에 command_id, bike_id, rental_id와 같은 식별자를 함께 기록하면 하나의 요청이 어떤 과정을 거쳤는지 추적하기가 더 편리해집니다. 단, CloudWatch만 연결한다고 전체 요청 흐름이 자동으로 추적되는 것은 아닙니다. 디바이스와 백엔드에서 공통 식별자를 전달하고 구조화된 로그를 남기도록 설계해야 합니다. 마지막으로 펌웨어 업데이트 문제도 생각해 볼 수 있습니다. 고객사와 디바이스 수가 늘어나면 펌웨어 버전을 관리하고 업데이트 상태를 확인하는 것이 점점 중요해집니다. 이때 IoT Jobs를 활용하면 대상 디바이스에 업데이트 작업을 배포하고 성공 또는 실패 상태를 확인할 수 있습니다. 하지만 IoT Jobs가 펌웨어 자체를 만들어 주는 것은 아닙니다. 하드웨어 모델별로 필요한 펌웨어를 빌드하고, 파일을 저장하고, 디바이스가 안전하게 다운로드하고 설치할 수 있도록 구성해야 합니다. 또한 업데이트 도중 전원이 끊기거나 설치에 실패했을 때 복구할 수 있는 방법도 중요합니다. 따라서 Jobs는 기존 OTA 시스템을 완전히 대체하는 기능이라기보다, 원격 작업 배포와 관리 기능을 개선하는 데 활용할 수 있는 도구라고 보는 편이 좋겠습니다.
새로운 아키텍처를 설계하는 것과 이미 운영 중인 시스템을 변경하는 것은 다른 문제입니다. 기존 서비스가 정상적으로 동작하고 있다면, 마이그레이션 과정에서 새로운 장애가 발생하지 않도록 하는 것이 중요합니다. 이 사례에서는 한 번에 모든 디바이스를 변경하는 대신 단계적으로 전환하는 방법을 생각해 보겠습니다. 가장 먼저 기존 디바이스들이 어떤 MQTT Topic을 사용하고 있는지, 어떤 Payload를 전송하는지 정리합니다. 백엔드에서도 해당 메시지를 어떤 서비스가 구독하고 있는지 확인해야 합니다. 예를 들어 MQTT Topic 이름을 변경했는데 디바이스 펌웨어에서 기존 Topic을 그대로 사용한다면 통신이 정상적으로 이루어지지 않을 수 있습니다. 그래서 기존 인터페이스를 최대한 유지하거나, 변경이 필요한 경우에는 호환성을 고려한 전환 계획이 필요합니다. AWS IoT Core에서는 디바이스마다 Thing을 등록하고 인증서와 Policy를 연결합니다. 이 과정에서 인증서가 올바른 디바이스에 연결되어 있는지, 해당 디바이스가 필요한 Topic에만 접근할 수 있는지 확인해야 합니다. 또한 인증서와 개인키를 디바이스에 안전하게 저장하는 방법도 중요합니다. 여러 디바이스에 같은 인증서나 개인키를 공유하는 방식은 피하는 것이 좋습니다. 모든 자전거를 한 번에 옮기기보다 테스트용 자전거 몇 대부터 연결해 보는 편이 안전합니다. 이때 다음 항목을 확인합니다.
  • AWS IoT Core 연결 및 인증 성공 여부
  • MQTT Publish/Subscribe 정상 동작
  • 기존 Topic과 Payload 호환성
  • 네트워크가 끊어진 후 재연결 동작
  • 명령 실행 및 ACK 처리
  • Shadow Desired/Reported 동기화
  • IoT Rules와 워커의 메시지 처리
  • 로그 및 오류 확인
이런 테스트에서 문제가 없다면 다음 그룹으로 확대할 수 있습니다. 운영 중인 시스템에서는 새 구조가 잘 동작한다는 확신이 들기 전까지 기존 브로커를 바로 종료하지 않는 것이 좋습니다. 예를 들어 먼저 일부 자전거를 AWS IoT Core로 전환하고, 나머지는 기존 MQTT 브로커를 사용하도록 유지할 수 있습니다. 단, 같은 명령이 두 브로커를 통해 중복 전송되지 않도록 주의해야 합니다. 명령 실행에는 command_id를 이용한 중복 처리 방지 로직이 필요합니다. 또한 문제가 발생했을 때 이전 MQTT 서버로 되돌릴 수 있도록 디바이스의 연결 설정과 배포 방법을 미리 준비해야 합니다. 특히 디바이스가 오프라인이거나 펌웨어 업데이트에 실패한 경우에는 원격 롤백이 어려울 수도 있습니다. 그래서 마이그레이션 자체보다 안전하게 전환하고 복구할 수 있는 구조를 만드는 것이 더 중요할 수 있습니다.
앞에서 여러 AWS 서비스를 소개했지만, 실제로 어떤 상황에서 도움이 되는지 살펴보면 조금 더 이해하기 쉽습니다. 사용자가 모바일 앱에서 자전거를 선택하고 대여 버튼을 눌렀습니다. 그런데 해당 자전거가 오프라인 상태라면 어떻게 해야 할까요? 우선 백엔드에서는 마지막 연결 상태와 상태 정보의 업데이트 시각을 확인할 수 있습니다. 정상적인 명령 실행이 불가능한 상태라면 대여를 바로 성공 처리해서는 안 됩니다. 명령을 전송했더라도 실제 ACK를 받지 못했다면 일정 시간 동안 결과를 기다리거나 실패 상태로 처리하는 정책이 필요합니다. 여기서 Device Shadow는 마지막으로 보고된 상태를 확인하거나 재연결 후 설정을 동기화하는 데 도움이 됩니다. 하지만 오프라인인 자전거를 즉시 잠금 해제할 수 있게 만들어 주는 것은 아닙니다. 중요한 것은 MQTT 명령을 보냈다는 사실이 아니라 실제로 사용자가 자전거를 이용할 수 있는 상태인지 확인하는 것입니다. A 회사는 GPS 데이터 전송 간격을 10초로, B 회사는 30초로 설정하고 싶다고 가정하겠습니다. 기존 구조에서도 백엔드에서 각 디바이스에 명령을 보내 설정을 변경할 수 있습니다. 그런데 설정을 변경하는 순간 디바이스가 오프라인이라면 어떻게 될까요? AWS IoT Device Shadow를 활용하면 서버가 원하는 설정을 Desired에 저장하고, 재연결한 디바이스가 해당 변경 사항을 확인하여 적용하도록 만들 수 있습니다. 적용이 완료되면 Reported에 실제 설정값을 기록합니다. 이렇게 하면 운영팀에서도 어떤 디바이스에 원하는 설정이 적용되었고, 어떤 디바이스에는 아직 적용되지 않았는지 구분하기가 편리해집니다. 자전거에서 전송된 배터리 잔량이 10% 이하로 내려갔다고 가정해 보겠습니다. 이런 경우 IoT Rules를 이용하여 해당 메시지를 필터링하고 SQS로 전달할 수 있습니다. 이후 Lambda나 워커에서 배터리 부족 이벤트를 처리하고 관리자에게 알림을 보냅니다. 하지만 배터리가 10% 이하인 동안 같은 메시지가 반복해서 들어오면 매번 알림을 보낼 필요는 없습니다. 따라서 최초로 임계값 이하로 내려갔을 때 알림을 보내고, 이후 상태가 회복될 때까지 중복 알림을 제한하는 로직이 필요합니다. 이런 작은 부분들도 실제 운영에서는 중요해집니다. 처음에는 bike/{bikeId}/telemetry와 같은 단순한 Topic 구조로 충분했을 수 있습니다. 하지만 여러 기업이 하나의 플랫폼을 사용한다면 고객사별로 데이터를 구분할 필요가 있습니다. 예를 들어 다음과 같이 Topic을 구성할 수 있습니다.
Text
tenant/
└── {tenantId}/
    └── bike/
        └── {bikeId}/
            ├── telemetry
            ├── status
            ├── cmd
            └── ack
이렇게 하면 Topic 구조에서 고객사와 자전거를 구분할 수 있습니다. 물론 Topic 이름만 분리한다고 해서 보안이 완성되는 것은 아닙니다. IoT Policy를 통해 디바이스별 Topic 접근 권한을 제한하고, 백엔드에서도 인증된 사용자가 자신이 속한 고객사의 데이터에만 접근하도록 검증해야 합니다. 데이터베이스와 운영 권한까지 함께 분리하는 것이 중요합니다.
아키텍처를 개선하는 가장 큰 이유는 새로운 AWS 서비스를 사용하는 것 자체가 아닙니다. 실제 서비스 운영에서 발생하는 문제를 줄이고, 운영팀과 개발팀이 더 중요한 업무에 집중할 수 있도록 만드는 것이 목적입니다. 예를 들어 자전거 100대 중 몇 대가 오프라인 상태인지 확인하는 데 매번 개발자가 서버 로그를 찾아야 한다면 운영 부담이 커질 수밖에 없습니다. 반대로 디바이스 상태를 한곳에서 확인하고, 문제가 발생했을 때 알림과 로그를 통해 원인을 파악할 수 있다면 운영 과정이 훨씬 편리해질 수 있습니다.
개선 항목기존 MQTT 구조개선된 아키텍처에서 기대하는 효과
디바이스 관리별도의 디바이스 관리 로직 필요Thing Registry 및 그룹 기반 관리
상태 동기화서버와 디바이스 상태 비교 로직 직접 구현Shadow Desired/Reported 기반 동기화
인증 및 접근 제어기존 브로커의 인증과 권한 체계 관리X.509 인증서 및 IoT Policy 기반 접근 제어
이벤트 처리백엔드에서 직접 메시지 구독 및 처리IoT Rules와 SQS/Worker로 처리 분리
장애 추적서비스별 로그를 직접 확인CloudWatch와 공통 식별자 기반 추적
OTA 작업별도 업데이트 및 배포 시스템 관리IoT Jobs를 통한 원격 작업 관리 가능
확장성브로커 및 운영 인프라 확장 직접 관리MQTT 브로커 운영 부담 감소
이 표는 가상 시나리오에서 기대할 수 있는 개선 방향입니다. 실제로 얼마나 효과가 있었는지는 운영 데이터를 통해 확인해야 합니다. 아키텍처를 변경했다고 해서 무조건 성공했다고 말할 수는 없습니다. 실제로 개선되었는지 확인하려면 측정할 수 있는 기준이 필요합니다. 예를 들어 다음과 같은 지표들을 비교할 수 있습니다.
측정 지표확인하고 싶은 내용
명령 실행 성공률잠금/해제 명령이 실제로 성공한 비율
명령 처리 시간명령 요청부터 실행 ACK까지 걸린 시간
디바이스 연결 상태오프라인 디바이스 수 및 연결 복구 시간
장애 탐지 시간문제가 발생한 후 발견하기까지 걸린 시간
신규 디바이스 등록 시간새 자전거를 서비스에 연결하는 데 걸리는 시간
OTA 업데이트 성공률원격 펌웨어 업데이트 성공 비율
운영 비용AWS 사용료, 기존 인프라 비용 및 운영 인력 투입 시간
특히 비용을 비교할 때는 서버 비용만 볼 것이 아니라 유지보수에 들어가는 개발 시간과 운영 업무까지 함께 고려할 필요가 있습니다. 예를 들어 AWS 사용료가 기존 서버보다 높아지더라도, 반복적인 운영 작업과 장애 대응에 필요한 시간이 충분히 줄어든다면 비즈니스 관점에서 합리적인 선택이 될 수도 있습니다. 반대로 디바이스 수가 적고 운영 요구사항이 단순하다면 기존 MQTT 서버를 유지하는 것이 더 경제적일 수도 있습니다. 이 사례에서 기대할 수 있는 가장 큰 변화는 다음과 같습니다. 첫 번째, 운영팀의 수동 작업을 줄일 수 있습니다. 디바이스 상태와 오류를 확인하기 위해 개발자에게 매번 요청하지 않아도 되는 구조를 만들 수 있습니다. 두 번째, 장애 대응 속도를 개선할 수 있습니다. 어떤 디바이스에서 문제가 발생했고, 어느 단계에서 오류가 생겼는지 추적할 수 있도록 설계하면 문제 해결 시간을 줄이는 데 도움이 됩니다. 세 번째, 새로운 고객사와 디바이스를 추가하기가 편리해질 수 있습니다. 디바이스 등록, 인증서, 권한, 설정 관리 구조가 표준화되어 있다면 새로운 장비가 추가될 때 반복되는 작업을 줄일 수 있습니다. 결국 아키텍처 개선은 단순히 기술을 교체하는 작업이 아니라, 서비스를 더 안정적으로 운영하고 성장시키기 위한 투자라고 생각합니다.
처음부터 AWS IoT Core를 선택해야 했을까요? 저는 꼭 그렇지는 않다고 생각합니다. 초기 MVP에서는 온프레미스 MQTT 브로커만으로도 충분히 필요한 기능을 구현할 수 있습니다. 오히려 처음부터 모든 기능을 만들려고 한다면 개발 기간과 비용이 늘어나 정작 중요한 비즈니스 검증이 늦어질 수도 있습니다. 하지만 서비스가 성장하고 요구사항이 달라진다면 아키텍처도 함께 바뀔 필요가 있습니다. 이번 사례에서 가장 중요하게 생각한 부분은 MQTT 서버를 AWS IoT Core로 교체하는 것 자체가 아니었습니다. 디바이스를 단순히 연결하는 구조에서 벗어나, 상태를 관리하고 장애를 추적하며 운영을 자동화할 수 있는 구조로 개선하는 것이 목적이었습니다. 물론 AWS IoT Core가 모든 문제를 해결해 주는 것은 아닙니다. 디바이스의 네트워크 연결, 펌웨어 안정성, 명령 중복 처리, 실제 하드웨어 제어, 고객사별 비즈니스 로직 등은 여전히 직접 설계하고 구현해야 합니다. AWS 서비스 사용량에 따른 비용과 특정 클라우드에 대한 의존성도 고려해야 합니다. 그래도 이미 AWS 인프라를 사용하고 있고, 여러 디바이스를 지속적으로 관리해야 하는 상황이라면 IoT Core가 좋은 선택지가 될 수 있다고 생각합니다. 이번 글을 정리하면서 다시 느낀 점은 한 가지입니다. 좋은 아키텍처는 처음부터 가장 복잡하고 완벽한 구조를 만드는 것이 아니라, 현재 비즈니스 요구사항을 만족하면서 앞으로 필요한 변화에 대응할 수 있는 구조를 만드는 것이라고 생각합니다. 다음에 비슷한 프로젝트를 만든다면 처음부터 다음 세 가지는 꼭 고려하고 싶습니다.
  • 디바이스가 오프라인이 되었을 때 어떤 방식으로 복구하고 상태를 동기화할 것인지
  • 명령 전송과 실제 명령 실행을 어떻게 구분하고 검증할 것인지
  • 디바이스가 늘어날 때 반복적인 운영 작업을 얼마나 자동화할 수 있을지
결국 서비스가 성장할수록 중요한 것은 단순히 기능을 더 많이 만드는 것이 아니라, 운영하기 좋은 시스템을 만드는 것이 아닐까 생각합니다.
Share this post
Alisher TogayevBackend & Cloud Engineer
LinkedIn
GitHub
Email
Backend & Cloud Engineer with 3+ years of experience connecting robots and IoT devices to the cloud. I operate 300+ smart farm modules across New York, Atlanta, Seoul and Incheon Airport at 99.9% uptime.